加权最小二乘法(WLS)与普通最小二乘法(OLS)的比较

作者

Li Zongzhang

发布于

2026年6月2日

1. 引言

普通最小二乘法(OLS)在经典假设下是最优线性无偏估计量(BLUE)。然而,当误差项存在异方差(即误差方差随解释变量的变化而变化)时,OLS 估计量虽然仍然无偏,但不再是有效的——存在更好的估计方法。

加权最小二乘法(WLS) 是处理异方差的经典方法:对每个观测值赋予不同的权重,方差较小的观测值获得更大的权重,从而提高估计效率。

本文通过数值模拟,直观展示 OLS 与 WLS 的差异。


2. 模型设定

考虑如下一元线性回归模型:

\[ y_i = \beta_0 + \beta_1 x_i + \varepsilon_i, \quad i = 1, 2, \ldots, n \]

异方差设定:误差项的方差随 \(x_i\) 剧烈变化:

\[ \varepsilon_i \sim N\left(0,\ \sigma^2 \cdot x_i^4\right) \]

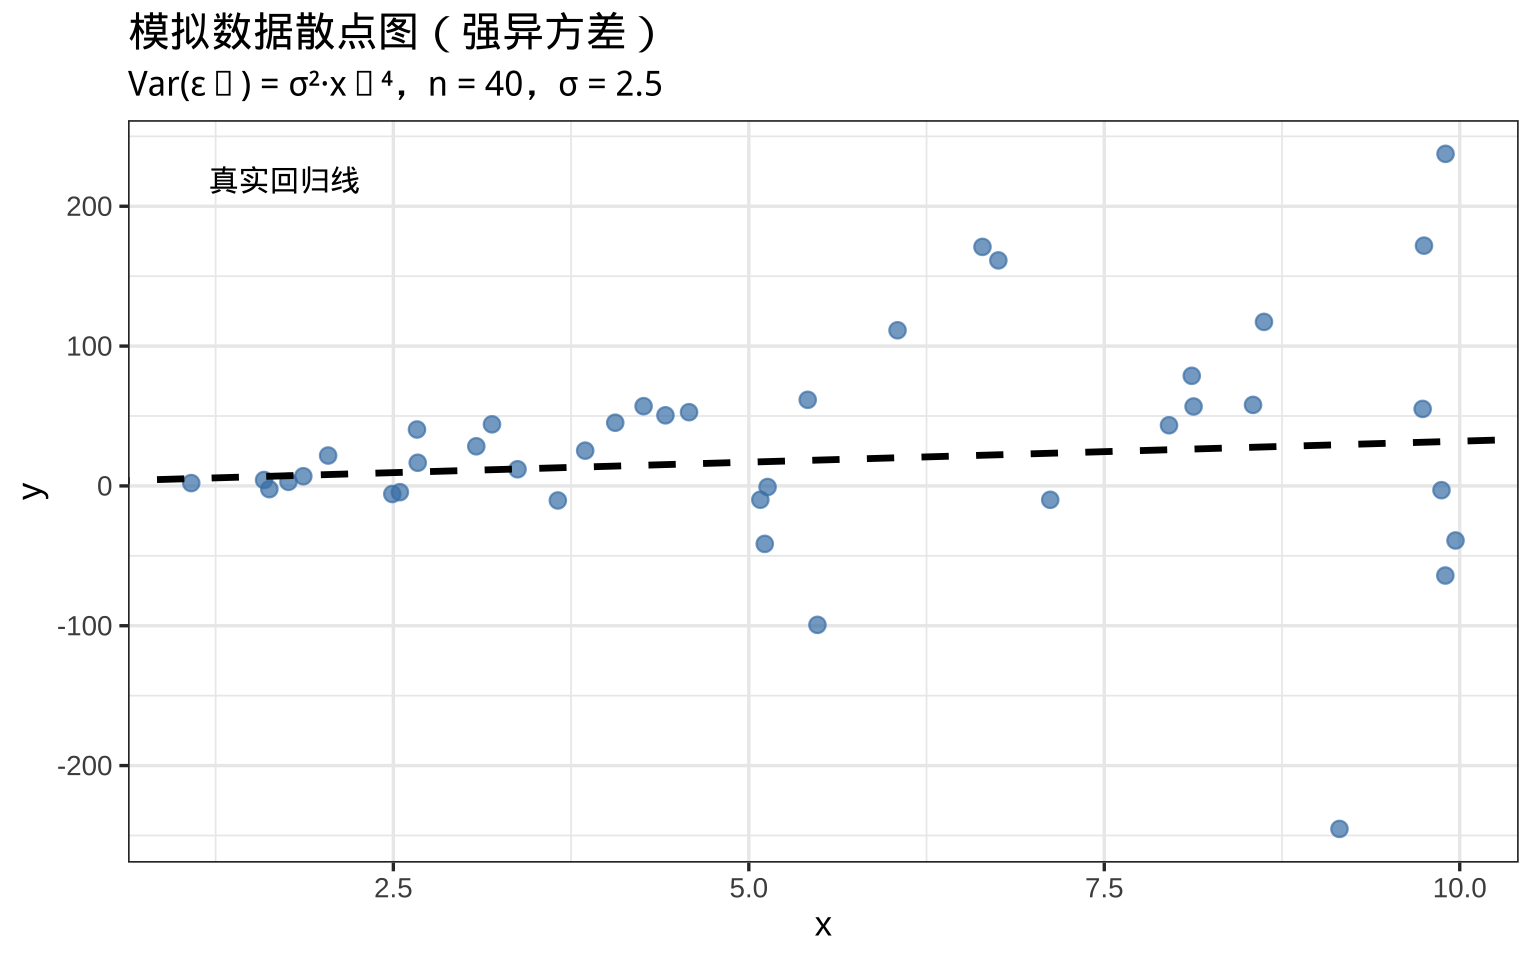
即标准差与 \(x_i^2\) 成正比。当 \(x_i = 1\) 时标准差约为 2.5,当 \(x_i = 10\) 时标准差高达 250,最大与最小方差之比达到 \(10^4\),异方差极为剧烈。

真实参数\(\beta_0 = 2\)\(\beta_1 = 3\)\(\sigma = 2.5\)\(n = 40\)


3. 数值模拟

3.1 生成模拟数据

代码
library(tidyverse)
library(broom)
library(knitr)
library(kableExtra)
library(patchwork)

# 设置随机种子,保证结果可复现
set.seed(7)

# 真实参数
beta0 <- 2
beta1 <- 3
sigma <- 2.5   # 较大噪声,使异方差效果更显著
n     <- 40    # 较小样本量,使单次估计波动更明显

# 生成解释变量:在 [1, 10] 上均匀分布
x <- runif(n, min = 1, max = 10)

# 异方差误差:Var(εᵢ) = σ² · xᵢ⁴,即 sd = σ · xᵢ²
# x=1 时 sd≈2.5,x=10 时 sd≈250,方差比高达 10000 倍
epsilon <- rnorm(n, mean = 0, sd = sigma * x^2)

# 生成因变量
y <- beta0 + beta1 * x + epsilon

# 整理为数据框
df <- tibble(x = x, y = y)

3.2 散点图:观察异方差

代码
ggplot(df, aes(x = x, y = y)) +
  geom_point(alpha = 0.7, color = "steelblue", size = 2.5) +
  geom_abline(intercept = beta0, slope = beta1,
              color = "black", linewidth = 1.2, linetype = "dashed") +
  annotate("text", x = 1.2, y = max(y) * 0.92,
           label = "真实回归线", color = "black", size = 4, hjust = 0) +
  labs(
    title    = "模拟数据散点图(强异方差)",
    subtitle = paste0("Var(εᵢ) = σ²·xᵢ⁴,n = ", n, ",σ = ", sigma),
    x = "x", y = "y"
  ) +
  theme_bw(base_size = 13)
图 1: 散点图:随着 x 增大,y 的波动(方差)急剧增加,呈现极强的异方差现象。

4. OLS 与 WLS 估计

4.1 OLS 估计

OLS 对所有观测值赋予相同权重,最小化残差平方和:

\[ \hat{\boldsymbol{\beta}}_{OLS} = \arg\min \sum_{i=1}^n (y_i - \beta_0 - \beta_1 x_i)^2 \]

在强异方差情形下,右端(\(x\) 大)的点波动极大,OLS 会被这些高方差点过度影响,导致估计偏离真实值。

fit_ols <- lm(y ~ x, data = df)
summary(fit_ols)

Call:
lm(formula = y ~ x, data = df)

Residuals:
     Min       1Q   Median       3Q      Max 
-292.260  -24.055    2.208   25.576  187.103 

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    5.102     27.162   0.188    0.852
x              4.572      4.432   1.032    0.309

Residual standard error: 79.57 on 38 degrees of freedom
Multiple R-squared:  0.02724,   Adjusted R-squared:  0.00164 
F-statistic: 1.064 on 1 and 38 DF,  p-value: 0.3088
4.2 WLS 估计

WLS 对每个观测值赋予不同权重,最小化加权残差平方和:

\[ \hat{\boldsymbol{\beta}}_{WLS} = \arg\min \sum_{i=1}^n w_i (y_i - \beta_0 - \beta_1 x_i)^2 \]

已知方差结构 \(\text{Var}(\varepsilon_i) = \sigma^2 x_i^4\),最优权重为:

\[ w_i = \frac{1}{\text{Var}(\varepsilon_i)} = \frac{1}{x_i^4} \]

这样,右端高方差的点权重极小(不被过度利用),左端低方差的点权重大(充分利用可靠信息)。

# 最优权重:wᵢ = 1 / xᵢ⁴(与方差结构匹配)
fit_wls <- lm(y ~ x, data = df, weights = 1 / x^4)
summary(fit_wls)

Call:
lm(formula = y ~ x, data = df, weights = 1/x^4)

Weighted Residuals:
    Min      1Q  Median      3Q     Max 
-4.4521 -1.1498  0.0189  1.2474  3.8342 

Coefficients:
            Estimate Std. Error t value Pr(>|t|)   
(Intercept)   -7.150      3.869  -1.848   0.0723 . 
x              7.588      2.273   3.338   0.0019 **
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.965 on 38 degrees of freedom
Multiple R-squared:  0.2268,    Adjusted R-squared:  0.2064 
F-statistic: 11.14 on 1 and 38 DF,  p-value: 0.001897

4.3 单次估计系数对比

代码
coef_ols <- tidy(fit_ols) |> mutate(方法 = "OLS")
coef_wls <- tidy(fit_wls) |> mutate(方法 = "WLS")

bind_rows(coef_ols, coef_wls) |>
  mutate(
    term   = recode(term, "(Intercept)" = "截距 β₀", "x" = "斜率 β₁"),
    真实值 = ifelse(term == "截距 β₀", beta0, beta1),
    偏差   = round(estimate - 真实值, 4)
  ) |>
  select(方法, 参数 = term, 真实值,
         估计值 = estimate, 偏差,
         标准误 = std.error,
         t统计量 = statistic, p值 = p.value) |>
  kable(digits = 4, align = "c") |>
  kable_styling(
    bootstrap_options = c("striped", "hover", "condensed"),
    full_width = FALSE
  ) |>
  row_spec(0, bold = TRUE, background = "#4472C4", color = "white")
表 1: 单次模拟的 OLS 与 WLS 系数估计(真实值:β₀ = 2,β₁ = 3)
方法 | 参数 | 真实 | 估计值 偏差 | 准误 | t统计 | p值
OLS 截距 β₀ | 2 | .1021 | .1021 | 7.1616 | .1878 | .8520 |
OLS 斜率 β₁ | 3 | .5719 | .5719 | .4322 | .0315 | .3088 |
WLS 截距 β₀ | 2 | 7.1505 | 9.1505 | .8686 | 1.8483 | .0723 |
WLS 斜率 β₁ | 3 | .5883 | .5883 | .2732 | .3382 | .0019 |

注意:单次估计可能因随机波动出现 OLS 比 WLS 更准的情况。判断估计量优劣应依据多次重复试验的平均表现,见第 5 节蒙特卡洛模拟。


5. 蒙特卡洛模拟:评估估计量的有效性

单次模拟带有随机性,无法准确反映估计量的统计性质。通过 1000 次重复模拟,我们可以系统评估两种估计量的无偏性与有效性。

代码
set.seed(2024)
B <- 1000

results <- map_dfr(1:B, function(b) {
  x_b   <- runif(n, 1, 10)
  eps_b <- rnorm(n, 0, sigma * x_b^2)
  y_b   <- beta0 + beta1 * x_b + eps_b

  ols_b <- lm(y_b ~ x_b)
  wls_b <- lm(y_b ~ x_b, weights = 1 / x_b^4)

  tibble(
    sim    = b,
    ols_b0 = coef(ols_b)[1],
    ols_b1 = coef(ols_b)[2],
    wls_b0 = coef(wls_b)[1],
    wls_b1 = coef(wls_b)[2]
  )
})

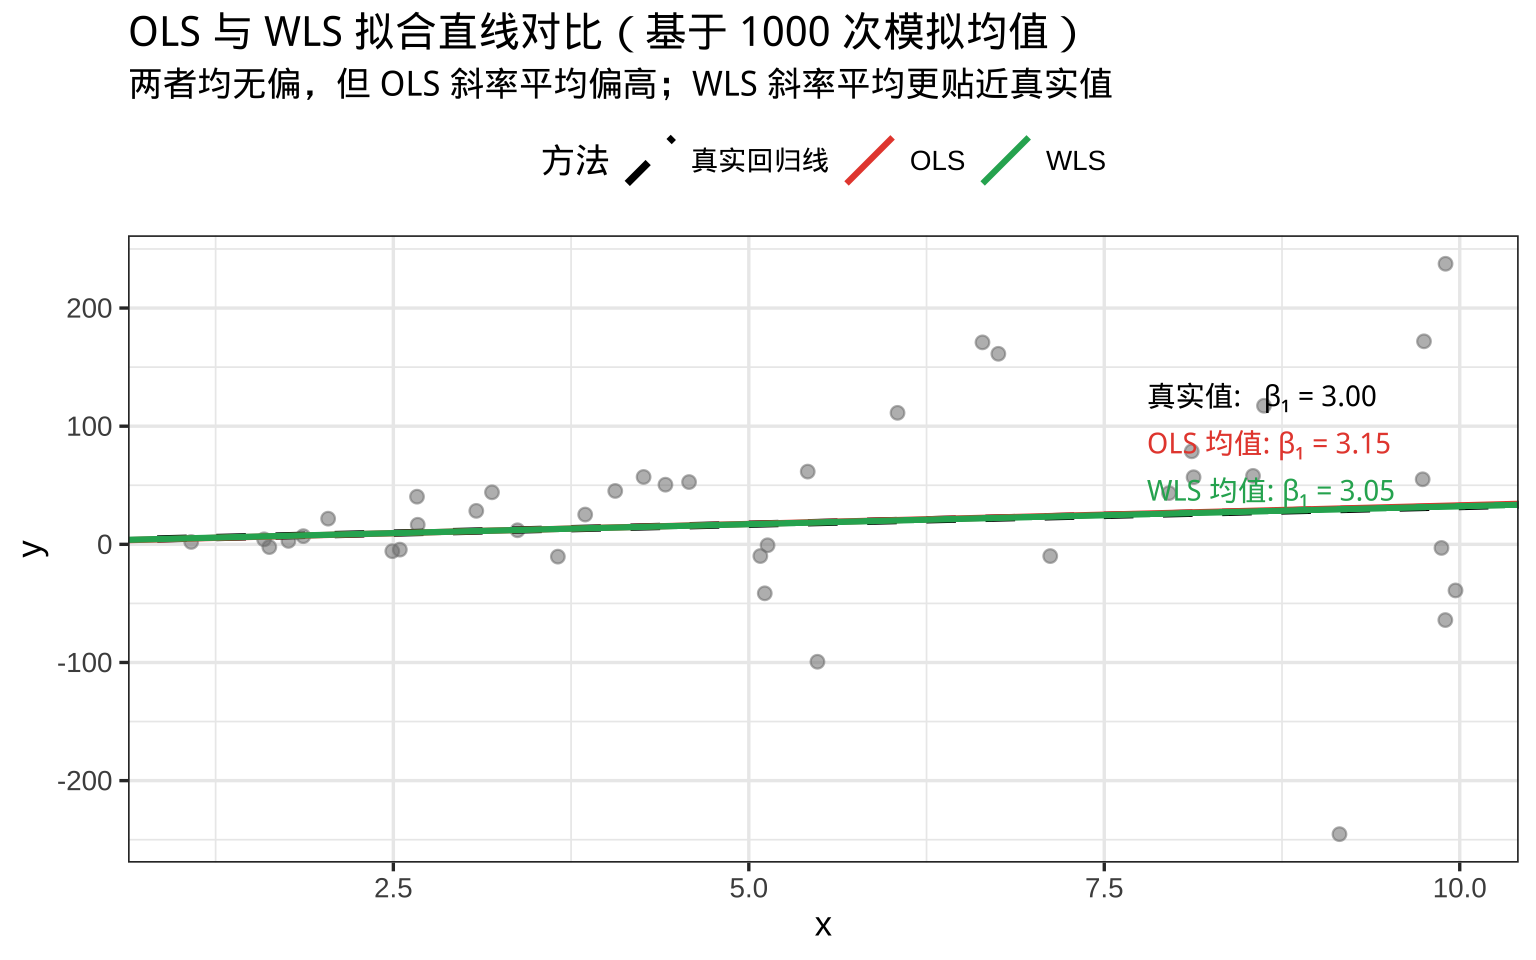
5.1 拟合直线对比图(基于 1000 次模拟均值)

单次估计可能因随机波动产生误导。这里用 1000 次模拟的平均系数画拟合线,能够客观反映两种方法的系统性差异。

代码
# 使用蒙特卡洛平均系数,消除单次随机波动的影响
b0_ols <- mean(results$ols_b0); b1_ols <- mean(results$ols_b1)
b0_wls <- mean(results$wls_b0); b1_wls <- mean(results$wls_b1)

ggplot(df, aes(x = x, y = y)) +
  geom_point(alpha = 0.55, color = "gray50", size = 2) +
  geom_abline(aes(intercept = beta0,  slope = beta1,
                  color = "真实回归线", linetype = "真实回归线"),
              linewidth = 1.3) +
  geom_abline(aes(intercept = b0_ols, slope = b1_ols,
                  color = "OLS", linetype = "OLS"),
              linewidth = 1.1) +
  geom_abline(aes(intercept = b0_wls, slope = b1_wls,
                  color = "WLS", linetype = "WLS"),
              linewidth = 1.1) +
  annotate("text", x = 7.8, y = beta0 + beta1 * 7.8 + 100,
           label = sprintf("真实值:   β₁ = %.2f", beta1),
           color = "black",   size = 3.8, hjust = 0, fontface = "bold") +
  annotate("text", x = 7.8, y = beta0 + beta1 * 7.8 + 60,
           label = sprintf("OLS 均值: β₁ = %.2f", b1_ols),
           color = "#E74C3C", size = 3.8, hjust = 0, fontface = "bold") +
  annotate("text", x = 7.8, y = beta0 + beta1 * 7.8 + 20,
           label = sprintf("WLS 均值: β₁ = %.2f", b1_wls),
           color = "#27AE60", size = 3.8, hjust = 0, fontface = "bold") +
  scale_color_manual(
    name   = "方法",
    values = c("真实回归线" = "black", "OLS" = "#E74C3C", "WLS" = "#27AE60"),
    breaks = c("真实回归线", "OLS", "WLS")
  ) +
  scale_linetype_manual(
    name   = "方法",
    values = c("真实回归线" = "dashed", "OLS" = "solid", "WLS" = "solid"),
    breaks = c("真实回归线", "OLS", "WLS")
  ) +
  labs(
    title    = "OLS 与 WLS 拟合直线对比(基于 1000 次模拟均值)",
    subtitle = "两者均无偏,但 OLS 斜率平均偏高;WLS 斜率平均更贴近真实值",
    x = "x", y = "y"
  ) +
  theme_bw(base_size = 13) +
  theme(legend.position = "top")
图 2: OLS 与 WLS 拟合直线对比(拟合线采用 1000 次模拟的平均系数)。OLS 平均斜率高估真实值;WLS 平均斜率更接近真实值 β₁ = 3,体现了 WLS 在异方差下的优越性。

5.2 估计量分布对比(斜率 \(\hat{\beta}_1\)

代码
results_long <- results |>
  select(sim, ols_b1, wls_b1) |>
  pivot_longer(-sim, names_to = "method", values_to = "beta1_hat") |>
  mutate(method = recode(method, "ols_b1" = "OLS", "wls_b1" = "WLS"))

# 各方法标准差,用于图内标注
sd_ols <- sd(results$ols_b1)
sd_wls <- sd(results$wls_b1)

ggplot(results_long, aes(x = beta1_hat, fill = method, color = method)) +
  geom_density(alpha = 0.35, linewidth = 1) +
  geom_vline(xintercept = beta1, linetype = "dashed",
             linewidth = 1.1, color = "black") +
  annotate("text", x = beta1 + 0.15, y = Inf,
           label = paste0("真实值 β₁ = ", beta1),
           vjust = 2, hjust = 0, size = 3.8, color = "black") +
  annotate("text", x = beta1 + 2, y = 0.25,
           label = sprintf("OLS SD = %.3f", sd_ols),
           color = "#E74C3C", size = 3.8, hjust = 0) +
  annotate("text", x = beta1 + 2, y = 0.20,
           label = sprintf("WLS SD = %.3f", sd_wls),
           color = "#27AE60", size = 3.8, hjust = 0) +
  scale_fill_manual(values  = c("OLS" = "#E74C3C", "WLS" = "#27AE60")) +
  scale_color_manual(values = c("OLS" = "#E74C3C", "WLS" = "#27AE60")) +
  labs(
    title    = "β₁ 估计量的抽样分布(1000 次模拟)",
    subtitle = "两者均无偏,但 WLS 方差更小(分布更集中)",
    x        = expression(hat(beta)[1]),
    y        = "密度",
    fill     = "方法",
    color    = "方法"
  ) +
  theme_bw(base_size = 13) +
  theme(legend.position = "top")
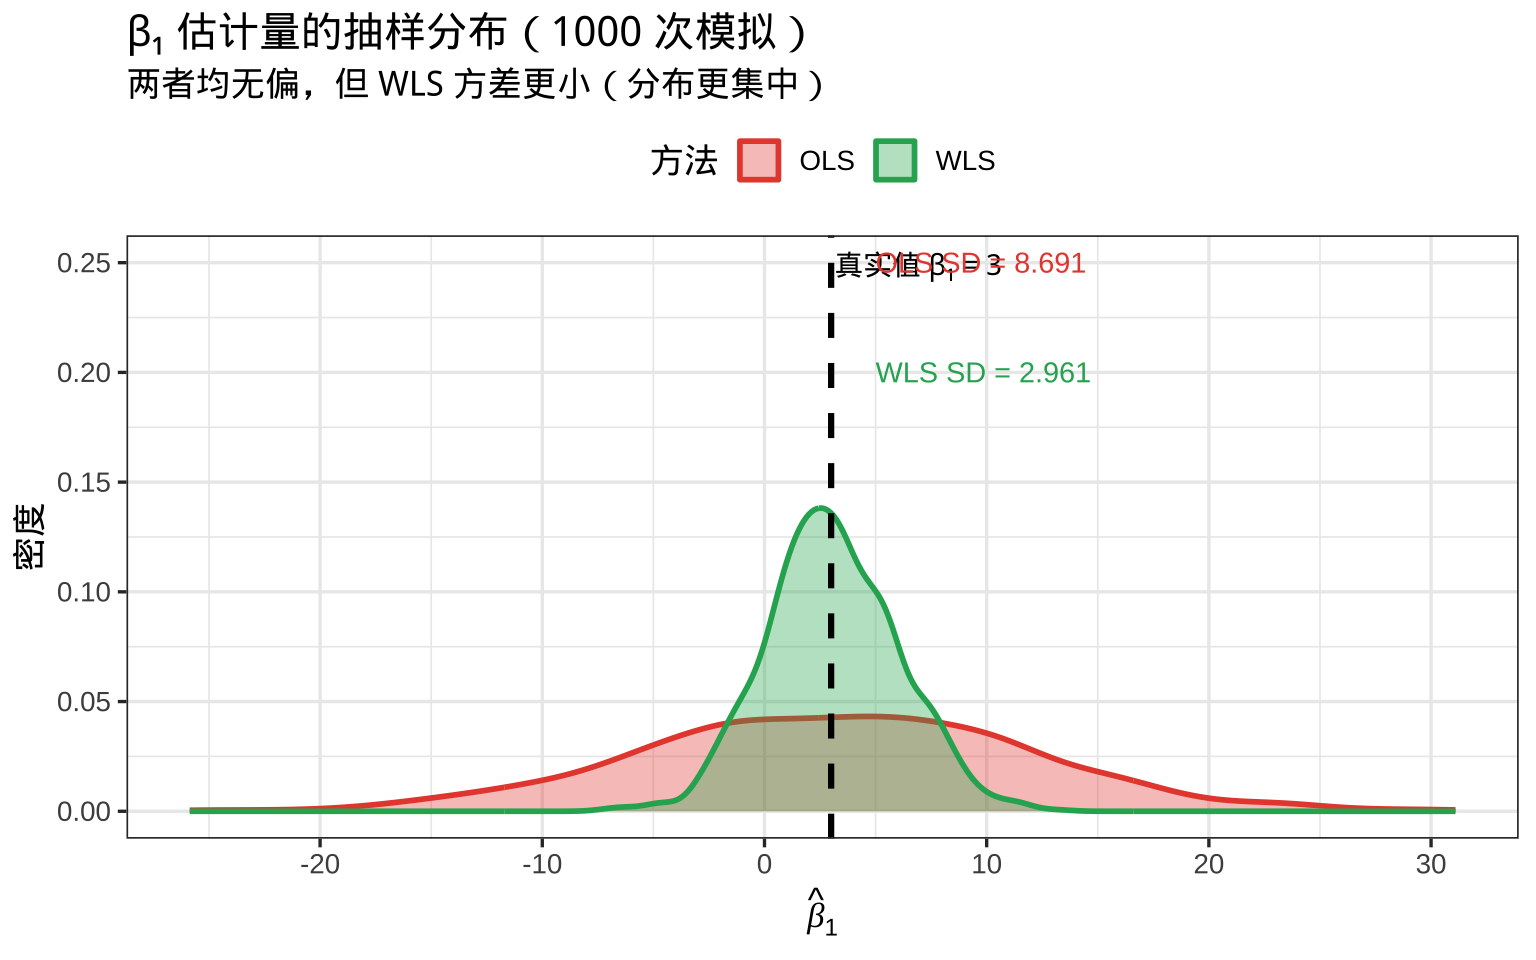
图 3: 1000 次模拟中 β₁ 的估计值分布。两种方法均无偏(分布中心都在真实值附近),但 WLS 的分布更集中(标准差更小),说明 WLS 更有效。

5.3 均值、标准差与均方误差(MSE)汇总

代码
summary_stats <- tibble(
  方法        = c("OLS", "WLS"),
  `β₀ 均值`  = c(mean(results$ols_b0), mean(results$wls_b0)),
  `β₀ 标准差`= c(sd(results$ols_b0),   sd(results$wls_b0)),
  `β₀ MSE`   = c(mean((results$ols_b0 - beta0)^2),
                  mean((results$wls_b0 - beta0)^2)),
  `β₁ 均值`  = c(mean(results$ols_b1), mean(results$wls_b1)),
  `β₁ 标准差`= c(sd(results$ols_b1),   sd(results$wls_b1)),
  `β₁ MSE`   = c(mean((results$ols_b1 - beta1)^2),
                  mean((results$wls_b1 - beta1)^2))
)

kable(summary_stats, digits = 4, align = "c") |>
  kable_styling(
    bootstrap_options = c("striped", "hover"),
    full_width = FALSE
  ) |>
  row_spec(0, bold = TRUE, background = "#4472C4", color = "white") |>
  add_header_above(
    c(" " = 1, "截距 β₀" = 3, "斜率 β₁" = 3),
    bold = TRUE
  )
表 2: 1000 次模拟的估计量统计性质汇总(真实值:β₀ = 2,β₁ = 3)
截距 β₀
斜率 β₁
方法 | ₀ 均值 | β₀ 标准差 | β₀ M E | β₁ 均值 | β₁ 标准差 β₁ MSE |
OLS 1.5490 32.9104 1082.2132 3.1474 8.6911 75.4815
WLS 1.8849 5.8974 34.7582 3.0545 2.9615 8.7646

解读:两种方法的均值都非常接近真实参数(无偏性),但 WLS 的标准差和 MSE 均明显小于 OLS,印证了在异方差下 WLS 是更有效的估计量。


6. 残差分析

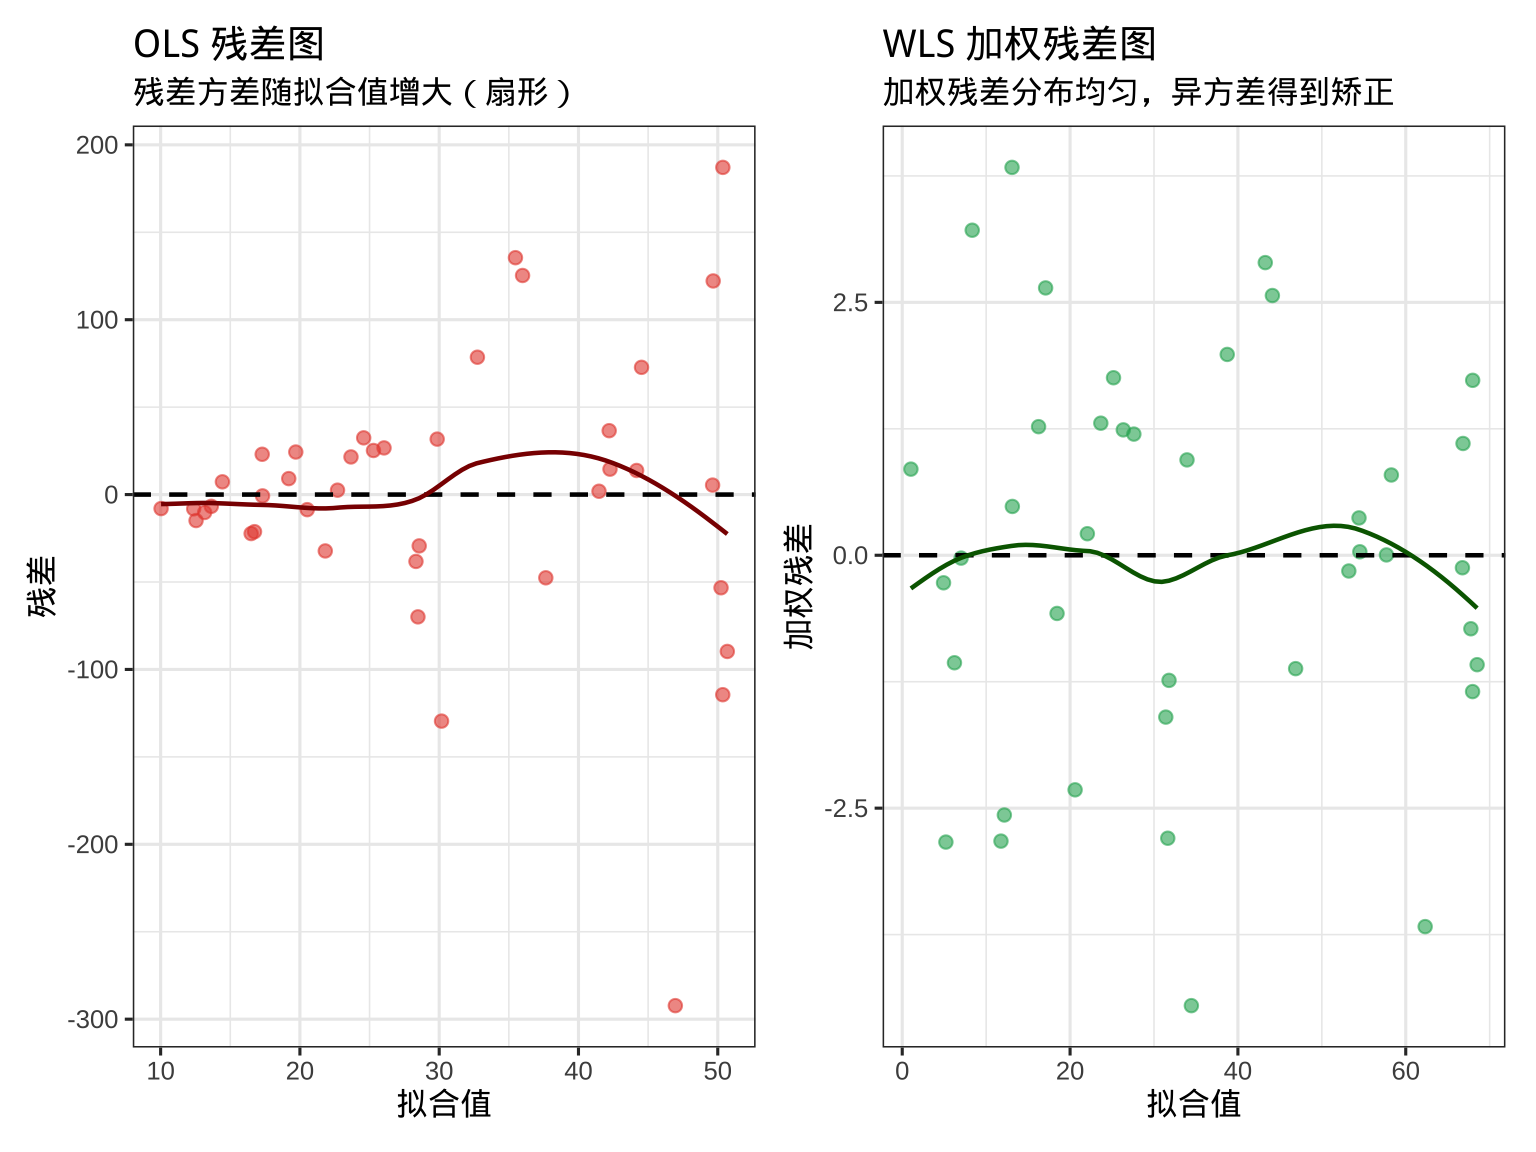
异方差的重要诊断工具是残差图

代码
p1 <- ggplot(
  data.frame(fitted = fitted(fit_ols), resid = resid(fit_ols)),
  aes(x = fitted, y = resid)
) +
  geom_point(alpha = 0.6, color = "#E74C3C", size = 2) +
  geom_hline(yintercept = 0, linetype = "dashed", linewidth = 0.8) +
  geom_smooth(se = FALSE, color = "darkred",
              linewidth = 0.8, method = "loess", formula = y ~ x) +
  labs(
    title    = "OLS 残差图",
    subtitle = "残差方差随拟合值增大(扇形)",
    x = "拟合值", y = "残差"
  ) +
  theme_bw(base_size = 12)

# WLS 加权残差 = 残差 / xᵢ²(还原为等方差尺度)
p2 <- ggplot(
  data.frame(fitted = fitted(fit_wls), resid = resid(fit_wls) / x^2),
  aes(x = fitted, y = resid)
) +
  geom_point(alpha = 0.6, color = "#27AE60", size = 2) +
  geom_hline(yintercept = 0, linetype = "dashed", linewidth = 0.8) +
  geom_smooth(se = FALSE, color = "darkgreen",
              linewidth = 0.8, method = "loess", formula = y ~ x) +
  labs(
    title    = "WLS 加权残差图",
    subtitle = "加权残差分布均匀,异方差得到矫正",
    x = "拟合值", y = "加权残差"
  ) +
  theme_bw(base_size = 12)

p1 + p2
图 4: 残差诊断图。OLS 残差呈现典型「扇形」(方差随拟合值增大而增大);WLS 加权残差则更为均匀,说明 WLS 成功矫正了异方差。

7. 关键结论

表 3: OLS 与 WLS 方法核心对比
比较维度 | OLS | WLS |
基本假设 | 同方差 | 许异方差 |
目标函数 | ∑ εᵢ² | ∑ wᵢεᵢ² |
权重设定 | 部为 1 | ᵢ = 1/σᵢ² |
无偏性 | ✓ 无偏 | ✓ 无偏 |
有效性(异方差下) | ✗ 非最有效 | ✓ 高斯-马尔科夫最优 |
适用场景 | 误差 差恒定 | 误差方差已知或可 计 |

核心要点

  1. 无偏性:OLS 和 WLS 都是无偏估计量,在多次重复试验中均值都收敛到真实参数。
  2. 有效性:在异方差存在时,WLS 的方差(标准误)更小,是更有效的估计量;OLS 被高方差的观测值”拖累”,估计的不确定性更大。
  3. 单次 vs. 平均:单次模拟中 OLS 偶尔可能比 WLS 更接近真实值,这是正常的随机波动。判断估计量优劣的标准是多次重复的平均表现(MSE),而非单次结果。
  4. 权重的作用:WLS 通过给低方差点赋予更大权重,充分利用”可靠”的信息,降低了估计的不确定性。
  5. 实践中的挑战:WLS 需要正确知道方差结构

参考资料

  • Greene, W. H. (2018). Econometric Analysis (8th ed.). Pearson.
  • Wooldridge, J. M. (2020). Introductory Econometrics: A Modern Approach (7th ed.). Cengage.
  • R Core Team (2024). R: A Language and Environment for Statistical Computing.